Sieve
محرك سحب بيانات من الويب يتكيف مع كل موقع: يختبر الموقع قبل لمسه، ويختار أخف طريقة ترى المحتوى الحقيقي، ويعيد نصًا نظيفًا بلا تكرار.
290
صفحة من 4 مواقع مختلفة جدًا خلال 2:13
4 من 4
مواقع اختار لها الفحص المحرك الصحيح
220
صفحة مكررة حُذفت تلقائيًا
75%
سقف المعالج الذي حافظ عليه منظّم الموارد
من داخل المنتج
شاهده وهو يعمل
شاشات حقيقية وتسجيل لتشغيل فعلي، مأخوذة من المنتج نفسه.
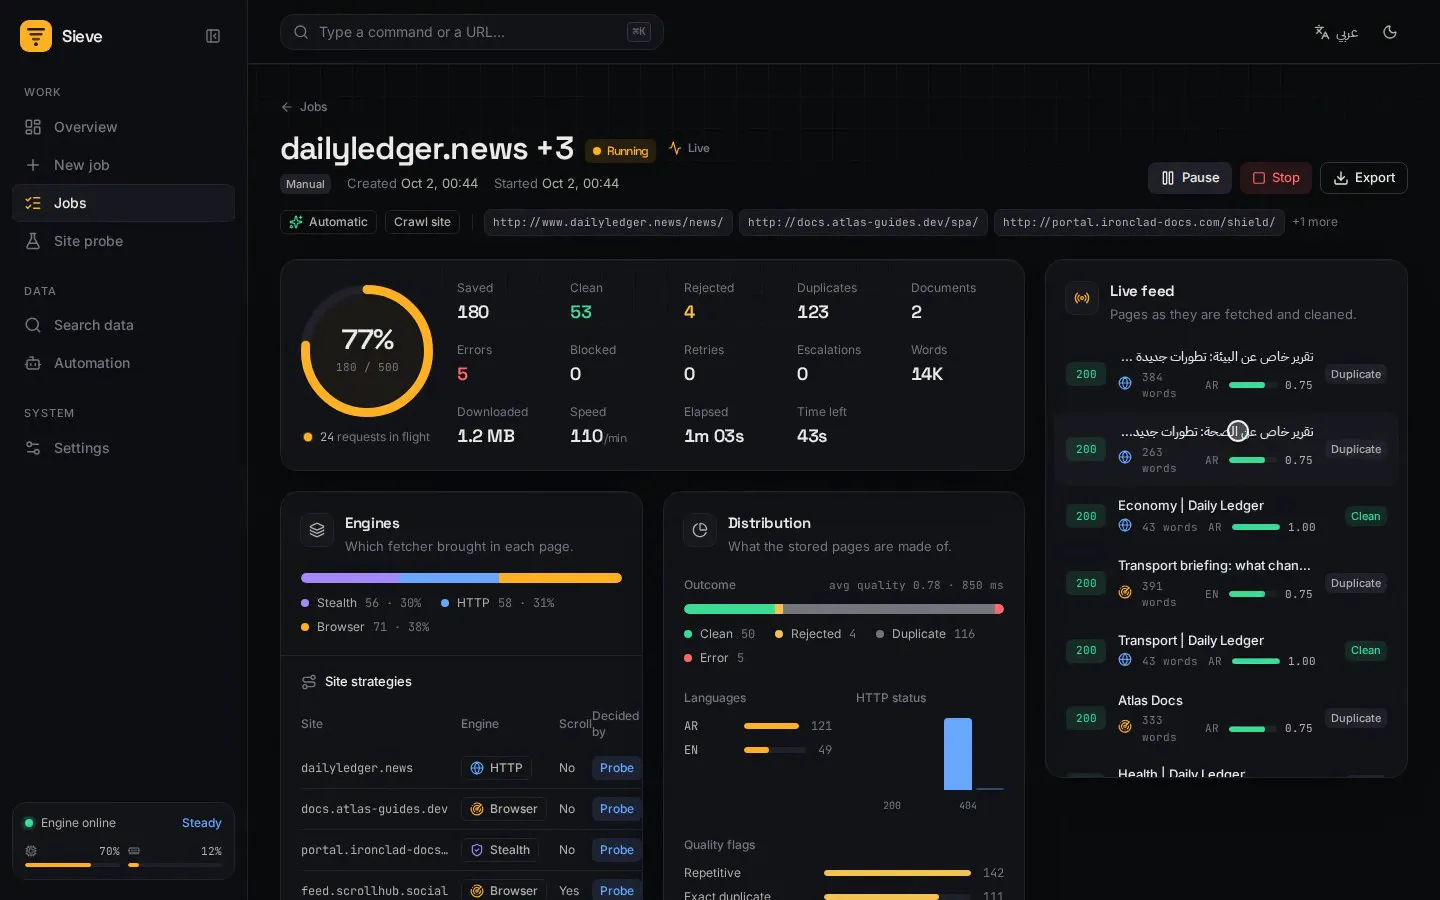
تشغيل حي على جهاز حقيقي: مؤشرات المعالج والذاكرة، ومنظّم الموارد يخفّف الحمل عندما تتجاوز الذاكرة سقف 80%.
01 / 27دوري
المهندس الوحيد على المشروع: فحص المواقع، محركات الجلب الثلاثة، منظّم الموارد، مسار التنظيف، وغرفة التحكم ثنائية اللغة.
المشكلة
معظم أدوات السحب ترسل الطلب نفسه لكل موقع وتتركك تنظف الفوضى: المواقع المحمية ترجع صفحات تحدٍّ، وتطبيقات JavaScript ترجع صفحات فارغة، وما يصل يكون مليئًا بالقوائم والتذييلات وأشرطة الكوكيز والتكرار. والضغط أكثر على جهاز عادي يرفع المعالج إلى 100%.
ما الذي بنيته
يبدأ Sieve كل موقع بفحص من ثماني خطوات: طلب عادي، كشف صفحات التحدي (Cloudflare وأمثالها)، مقارنة HTML الثابت بنسخة معروضة، قراءة robots.txt، اكتشاف خرائط الموقع والخلاصات، وفحص بنية الصفحة. والنتيجة خطة فيها المحرك وطريقة الاكتشاف والتزامن لكل نطاق والتأخير والتمرير ووضع الاستخراج، مع درجة ثقة والأسباب بكلمات واضحة.
أثناء الزحف يبدأ كل موقع بالمحرك الذي اختاره الفحص ويصعّد تلقائيًا عند الحجب أو عند وصول صفحة JavaScript فارغة: HTTP/2 أولًا، ثم بصمة TLS بمستوى المتصفح («Stealth»)، ثم Chromium بلا واجهة مع التمرير والتقاط الـAPI. ثم تمر كل صفحة بمسار تنظيف: استخراج المحتوى الرئيسي مع مطابقته بـtrafilatura، وتعلّم الكتل المتكررة عبر الموقع وحذفها من كل الصفحات، وتوحيد النص العربي واللاتيني، وكشف اللغة، وتقييم الجودة، وحذف التكرار التام والقريب (SHA-256 وSimHash)، وحجب البيانات الشخصية اختياريًا. وتُحمّل روابط PDF وDOCX وPPTX وXLSX ويُستخرج نصها، وحقول الذكاء الاصطناعي الاختيارية تستخدم Gemini لملء قيم محددة النوع لكل صفحة من وصف بلغة عادية.
المعمارية
محرك Python وFastAPI مع httpx (HTTP/2) وcurl_cffi (بصمات TLS للمتصفحات) وPlaywright Chromium، وlxml وtrafilatura للاستخراج، وaiosqlite على SQLite مع FTS5 للتخزين والبحث النصي الكامل. غرفة تحكم Next.js 16 مصدّرة كملفات ثابتة مع React 19 وTailwind CSS 4 وMotion وTanStack Query وZustand، يخدمها المحرك وتتحدث مباشرة عبر WebSocket. يمكن إيقاف المهام واستئنافها وإعادة تشغيلها وجدولتها بتشغيلات تزايدية أو بدؤها بوضع ملف في مجلد وارد، وتُستأنف بعد أي تعطل.
التحديات
الوصول لأقصى سرعة يسمح بها الجهاز دون بلوغ 100% أبدًا. منظّم موارد يقيس المعالج والذاكرة كل ثانية ويرفع التزامن أو يخفضه (AIMD) ضمن سقوف Eco أو Balanced أو Turbo أو Custom، بينما يحصل كل نطاق على مخفّض سرعة خاص يتراجع عند 429 وRetry-After والاستجابات البطيئة. ومصائد الزحف مثل صفحات التقويم وسلاسل المعاملات اللانهائية لها حدود.
القرارات الهندسية
الفحص أولًا ثم أخف محرك يرى المحتوى الحقيقي، لأن المتصفح لكل صفحة بطيء وHTTP العادي يفوّت نصف الويب الحديث. تعلّم الكتل المتكررة عبر الموقع بدل تخمينها لكل صفحة. وكل اختيار للمحرك قابل للشرح ويمكن فرضه يدويًا.
النتائج والأثر
في مهمة مسجلة على أربعة مواقع اختبار مختلفة جدًا (بوابة أخبار عربية وإنجليزية تُعرض من الخادم، وتطبيق توثيق يعمل بـJavaScript فقط، وقاعدة معرفة خلف حماية بوتات بأسلوب Cloudflare، وخلاصة بتمرير لانهائي)، اختار الفحص المحرك الصحيح لكل موقع: HTTP للبوابة (36 رابطًا من خريطة الموقع)، وBrowser لتطبيق JavaScript (9 كلمات في HTML الخام مقابل 216 بعد العرض)، وStealth للموقع المحمي (HTTP العادي تلقى تحدي 403 وبصمة المتصفح عبرت)، وBrowser مع التمرير التلقائي للخلاصة. جلب 290 صفحة خلال دقيقتين و13 ثانية، وحذف 220 مكررًا و280 كتلة قالب متكررة، واستخرج 4 مستندات، واحتفظ بـ47 صفحة نظيفة وفريدة بمتوسط جودة 0.80، بينما حافظ المنظّم على المعالج تحت سقف 75%. وفي تشغيل ثانٍ ملأ Gemini أربعة حقول ذكية لـ6 مقالات عربية وإنجليزية باستدعاء واحد لكل صفحة.
أبرز النقاط
- أي إدخال: روابط أو نص ملصوق، TXT وCSV وTSV وJSON وXLSX وخرائط المواقع وHTML
- فحص من ثماني خطوات لكل موقع مع خطة موصى بها ودرجة ثقة وأسباب
- ثلاثة محركات مع تصعيد تلقائي لكل صفحة ولكل موقع، أو اختيار يدوي
- منظّم موارد بمؤشرات مباشرة للذاكرة المستخدمة والمتاحة والمحجوزة وأربعة ملفات موارد
- زحف مهذب: تحديد سرعة لكل نطاق، Retry-After، robots.txt، وحدود لمصائد الزحف
- مسار تنظيف يحذف القوالب المتكررة عبر الصفحات ويوحّد النص العربي ويقيّم الجودة ويحذف التكرار القريب
- حقول منظمة عبر CSS أو XPath أو Regex، وحقول ذكاء اصطناعي من Gemini بمخطط محدد النوع
- بحث نصي كامل وتصدير إلى JSONL وJSON وCSV وExcel وMarkdown ونص عادي
- جدولات ومجلد وارد ونقاط استئناف آمنة من التعطل
- غرفة تحكم عربية وإنجليزية مع دعم كامل للاتجاه من اليمين لليسار، وضع داكن وفاتح، ولوحة أوامر
- اختُبر مباشرةً على مواقع حقيقية من جهاز Windows: Indeed خلف Cloudflare عبر محرك التخفي، وجدار DataDome في G2 مع الإفصاح عنه بوضوح، وHacker News بمهلة 30 ثانية كما يطلب ملف robots.txt